





近期DANGO收到國內外較多有關「AI生成」歌曲提取的回饋,基本都在詢問這類歌曲的提取品質。
因此有必要另開文章,統一說明這類歌曲的品質、提取及未來相容性問題。
DANGOAI能否提取「AI生成類」歌曲?
先說簡短結論:目前11.0算法能有限支援,即將到來的12.0將更完整支援這類音訊,除了模型整體效能大幅提升,也會針對「AI生成」音訊提取做定向優化。
AI曲風違反慣常模式
以Suno為主的AI音樂生成軟體已問世幾年,今年這類歌曲更大量湧現。不只網路隨處可見,連實體便利商店、商場也常聽到AI生成歌曲。
去年中DANGO11.0系列發布時,就已注意這類音樂,但當時未深入優化,原因是,AI生成音樂的性質非常不穩定,限制了11.0階段的定向優化。
多數聽眾主要在意歌曲「好不好聽」,但從DANGO技術角度,音軌「準不準確」才是關鍵。AI生成音樂的人聲、伴奏界線模糊:人聲常哼唱到一半,便逐漸被某種伴奏樂器取代;反過來,伴奏也不守規矩,例如原本規律的鼓組,可能因人聲遮蔽突然「不生成」——這部分鼓組確實少了一個音色、缺了一塊,只被歌聲的特殊聲音(如齒音)蓋住,一般聽眾難以察覺。
另外,AI生成的「人聲」也非常……誇張🤨(懂的都懂.jpg)。經常能哼唱出許多人類喉嚨難以唱出的驚人聲音,這些「反常識」音訊模式在AI中反而常見,與大量使用真實音樂訓練的DANGOAI路線相反,讓這類風格難以提取。
這與AI音樂訓練機制有關。它像大型語言模型一樣需要後訓練:先生成N首歌曲,由內部或志工評分,再將「人類覺得最好」的音訊餵給自己,「左腳踩右腳」地迭代出人類更喜歡的音樂。
但除非受過專業訓練,多數人難以聽出上述「音色漸變融合」、「樂器缺失」等瑕疵,評分更看重整體好不好聽、音準對不對,導致AI受人類評分影響,更不在意「準確」,只在意「好不好聽」,與使用者喜好互相靠攏。
相反地,DANGO提取算法根本不在意歌好不好聽、唱得走不走音。只要是人聲,無論「深情演唱」或「鬼哭狼嚎」都能正常提取。真正在意的是音樂底層結構——唱到一半人聲突然與樂器混成一團、伴奏無故缺失,這些正常音樂根本不可能出現的問題,在AI歌曲卻是家常便飯。
面對違反正常音樂結構的內容,目前11.0只能靠原有「真實歌曲提取能力」應付;遇到結構過於混亂的AI歌曲,提取就容易失效。
打不過就加入?
有些人可能想問,說這麼多,讓DANGO學習AI歌曲不就好了。
一刻也不能停歇,馬上迎來的第一件事就是——版權。
以Suno為例,產品條款(Conditions of Access and Use 10.)嚴格禁止使用其生成輸出進行任何二次AI訓練。
更糟的是,即使沒有這種條款限制,DANGO仍無法從這類歌曲學習受益🤣
簡單來說,DANGO這類分離模型學習需要極其乾淨的人聲和伴奏音軌,並從它們的混音過程,學習如何反向拆分提取。但AI生成歌曲不是「內部生成N種音軌」,最後再混合呈現給大家,而是在輸出時直接輸出最終音訊。
這表示這類歌曲天生只有混音,本來就不存在「乾淨的各種音軌」,因此無法從中學習。
Suno確實有「音軌提取」,但品質令人擔憂,大多還不如DANGO可靠。即便用Suno提取各種音軌,也不是「乾淨」的。無論用DANGO11.0或Suno提取,都帶有各類錯誤——使用這類錯誤音訊,期望「左腳踩右腳」讓DANGOAI重新學習,只會讓提取效能變差。
AI生成歌曲本身的偽影問題
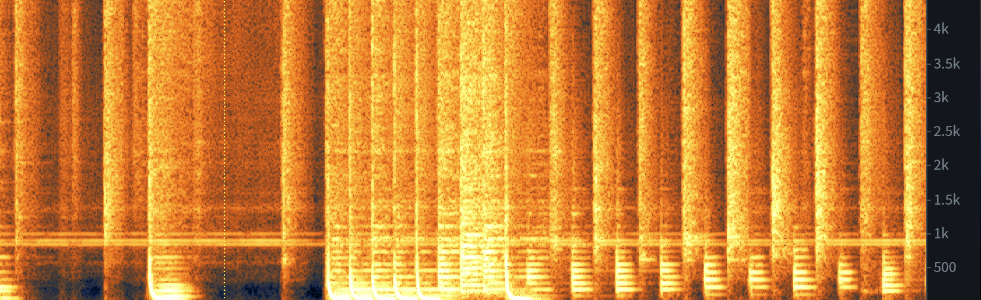
DANGO音訊研發團隊近期注意到,Suno自8月發布v6後,v6生成音訊有強烈偽影痕跡,經DANGO(或其他算法)移除人聲後,剩下伴奏會有明顯中低頻嗡鳴偽影。
DANGO不清楚這是Suno某種刻意加入的「浮水印」,還是算法缺陷,但已知的是——此浮水印在原始歌曲中,因人耳遮蔽效應而難以聽清,移除人聲後,卻能在剩餘伴奏裡明顯察覺,使輸出伴奏已達無法使用的程度。
然後呢?DANGO的對策是?
由於「AI生成」歌曲本身不存在「原始人聲/伴奏」,DANGO無法從中學習,提升對這類風格的移除能力。再加上8月份開始的浮水印問題,讓提取「AI生成」歌曲變得越來越具挑戰性😰
——以上是前面的鋪陳(不先說困難挑戰,怎能知道DANGO研發優化的艱辛.jpg),接下來想說:
DANGO12.0將定向優化此類音訊提取、移除「浮水印偽影」,大幅提高提取準確性👻👻👻👻
12.0立項時就已整理這些問題和挑戰,作為優化目標之一——當然坦白說,提升「AI生成」歌曲提取能力,在12.0中甚至不值一提,12.0對任何歌曲、任何曲風都會有非常明顯的準確性提升👻
已找到可行的定向優化方式,並實驗成功。內部測試中,「AI生成」音訊的錯誤提取率極大幅減少(如常將某些樂器當作人聲移除)。
屆時12.0全系列算法還會提供額外選項,勾選後可定向移除AI生成的浮水印偽影。已為此類音訊做好一切體驗優化,只為對音質極度苛刻的您👻


